
В первой части этого кейса Дамир Ильдарович Марапов у себя в канале разобрал методологическую сторону: что такое конфаундинг, почему в нерандомизированном исследовании простого сравнения групп может быть недостаточно и как подходить к выбору потенциальных конфаундеров.
А здесь разберём тот же пример уже практически — в R.
Напомню исходные данные:
120 пациентов после планового хирургического вмешательства,
по 60 человек в каждой группе.
Средняя длительность госпитализации:
новый протокол — 5,5 дня
стандартный — 6,8 дня
1. Исходное сравнение
Начнём с обычного сравнения двух независимых групп:
t.test(hospital_days ~ protocol, data = dat)Получаем разницу около 1,3 дня, p = 0,008 — при округлении p ≈ 0,01.
То есть без учёта других факторов длительность госпитализации в группе нового протокола статистически значимо меньше.
Но исследование нерандомизированное, поэтому важно оценить, насколько сопоставимы сами группы.
2. Возраст пациентов
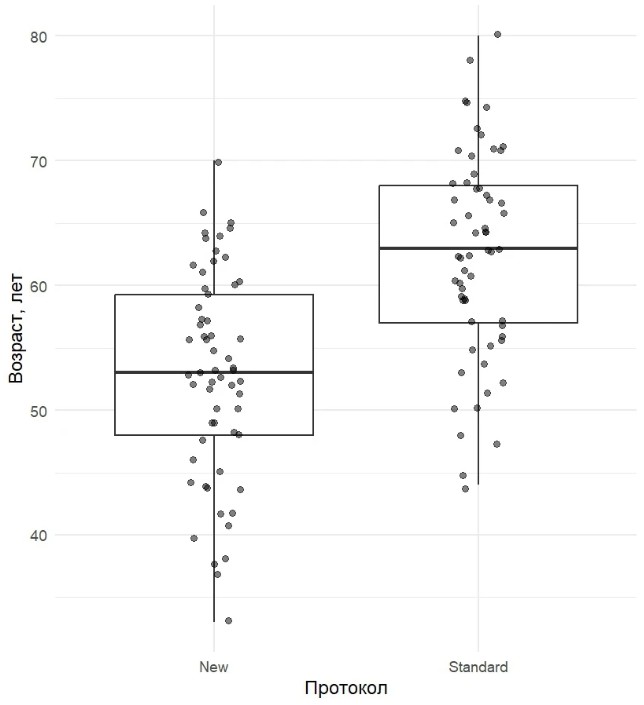
Средний возраст:
новый протокол — 52,9 года
стандартный — 62,4 года
Почти 10 лет разницы.
Посмотрим, как распределяется возраст внутри каждой группы.
Для визуализации используем ggplot2 — пакет R, который позволяет собирать графики из отдельных слоёв. Здесь совместим boxplot с отдельными наблюдениями: так видны и распределение, и данные каждого пациента.
ggplot(dat, aes(protocol, age_years)) +
  geom_boxplot() +
  geom_jitter(width = 0.1, alpha = 0.5)
Различие в возрасте между группами хорошо видно и на графике.
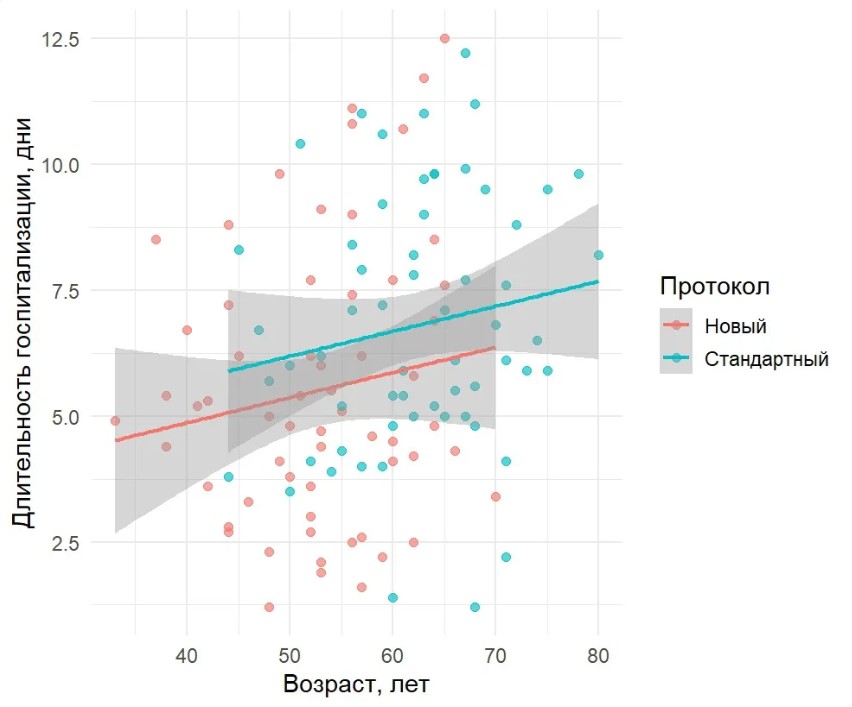
Теперь оценим, как связаны возраст и длительность госпитализации:
ggplot(dat, aes(age_years, hospital_days, colour = protocol)) +
  geom_point(alpha = 0.6) +
  geom_smooth(method = "lm")
Каждая точка — один пациент, линии показывают линейную тенденцию внутри групп. В обеих группах с увеличением возраста длительность госпитализации имеет тенденцию увеличиваться.
С учётом методологической логики, разобранной в первой части, возраст имеет смысл включить в анализ как потенциальный конфаундер.
3. Учитываем возраст
Для этого используем линейную регрессию. Она позволяет оценить связь протокола с длительностью госпитализации, одновременно учитывая возраст пациента.
В R линейная модель задаётся функцией lm(). Слева указываем исход — длительность госпитализации, справа — протокол и возраст:
model <- lm(
  hospital_days ~ protocol + age_years,
  data = dat
)

summary(model)
confint(model)
summary() показывает коэффициенты модели и p-value,
а confint() — 95% доверительные интервалы.
До учёта возраста различие между протоколами составляло около 1,3 дня.
После поправки на возраст оценка уменьшается до 0,82 дня. Для протокола p ≈ 0,14, а 95% доверительный интервал включает 0.
То есть после учёта возраста различие между группами становится менее выраженным и статистически менее определённым.
Это не означает, что мы доказали отсутствие эффекта. Но и сказать:
«новый протокол сокращает госпитализацию на 0,8 дня»
по этим данным нельзя.
Корректнее сказать так: после поправки на возраст оценка различий между протоколами уменьшилась примерно до 0,8 дня, а 95% доверительный интервал включает 0 — поэтому по этим данным нельзя исключить отсутствие различий между протоколами.
Именно для этого здесь и нужна модель: посмотреть, как меняется оценка после учёта важного исходного различия между группами.
При этом технически весь анализ в R занимает совсем немного кода: t-test, два графика и линейная модель.
Когда статистическая задача сформулирована, реализовать её в R часто можно всего несколькими строками.
Для практикума мы подготовили учебный датасет и полный R-скрипт с комментариями, чтобы весь анализ можно было скачать и повторить самостоятельно: https://t.me/medstatistic_ru/352
Добавить комментарий